Framework zuerst lesen
Für Leser, die verstehen möchten, wie Rollen, Governance, Requirement, Story, Solution, Architecture, Decision, Delivery und Evidence zusammenspielen.
Simulate. Understand. Decide.
Ein Multi-Agenten-Framework, das einen Change Request so prüft wie ein echtes Projektteam: Business Analyst, Product Owner, Developer, Solution Architect und Tester agieren in ihrer klassischen Rolle, mit eigener Perspektive, eigener Verantwortung und eigenem Urteil. Wie im echten Projekt entsteht die Entscheidung aus dem Zusammenspiel fachlicher und technischer Sichten, nicht aus einer Einzelmeinung. Und wie im echten Projekt kann jede Rolle eine Freigabe stoppen, wenn ihre fachlichen oder technischen Kriterien nicht erfüllt sind.
Entwickelt in drei Stufen: gestartet auf lokaler Hardware, heute auf einer GPU-Cloud. Jeder Lauf ist dokumentiert, verifiziert und vergleichbar.
🔍 Vergrössern
Die Simulation ist kein einzelner Schritt, sondern ein geschichteter Prozess. Der sichtbare Ablauf im Report, die innere Verarbeitung im Agent Swarm, die technische Pipeline pro Agent und die Härtungen zwischen den Versionen greifen ineinander. Ein Wechsel zwischen den Ebenen zeigt, wie kompakt die Entwicklung tatsächlich ist.
Von der rohen Anforderung bis zur vollständigen Nachvollziehbarkeit. Jeder Bereich ergänzt eine eigene Perspektive, erst aus dem Zusammenspiel entsteht der konsolidierte Entscheidungsreport.
Sechs Verarbeitungsschichten bilden die Kernlogik. Requirement, Story, Delivery und Evidence sind daraus abgeleitete Ergebnisräume.
Querliegende Zusatzschicht: Knowledge SMART_ROUTING speist jede Rolle mit rollenbezogenem Kontext, bevor sie bewertet.
Jede Rolle durchläuft dieselbe technische Pipeline. Nicht valide Outputs verschwinden nicht, sondern bleiben als Fallback in der Evidenz sichtbar.
Acht technische und semantische Härtungen. Keine neuen Funktionen, sondern kontrollierte Verschärfung der bestehenden Verarbeitung.
Diese Seite ist die Startseite des Frameworks. Von hier aus gibt es drei klare Wege: zuerst die Methode verstehen, den aktuellen MVP-Stand ansehen oder direkt konkrete Runs vergleichen. So bleibt die Simulationserklärung erhalten, ohne dass jeder Leser zuerst durch alle Details scrollen muss.
Für Leser, die verstehen möchten, wie Rollen, Governance, Requirement, Story, Solution, Architecture, Decision, Delivery und Evidence zusammenspielen.
MVP 1.0 und MVP 1.1 sind auf dem NAB9 abgeschlossen. Die aktive Weiterentwicklung läuft getrennt im MVP-2.0-Repository auf einer NVIDIA RTX 3090 mit 24 GB VRAM. Erste GPU-Smoke-Tests und ein vollständiger Fünf-Rollen-Gruppenlauf sind vorhanden; methodisch identische Vergleichsruns stehen noch aus.
Die Gallery zeigt konkrete Simulationen als kuratierte Run-Karten. Dort werden Governance-Status, Modell, Hardware, Knowledge-Kontext, Mängelbild und Empfehlung je Run vergleichbar.
Anforderungen werden in der Regel schriftlich, strukturiert und nach Priorität geordnet eingereicht. Der Empfänger hängt vom Kontext ab. Im Arbeitsalltag sind es meist interne IT-Teams, das Produktmanagement oder die Projektleitung, abgewickelt über Ticketsysteme wie Jira, Azure DevOps, ClickUp, ServiceNow oder Asana.
Anforderungen für Prozessanpassungen, Change Requests, Bug-Fixes oder neue Initiativen sind in der Praxis fachlich häufig schlecht beschrieben. Implizites Wissen wird vorausgesetzt, die Schnittstellen zwischen Fachbereich und IT bleiben unklar, und Anforderungen werden oft als Lösung statt als Problem formuliert.
In agiler Softwareentwicklung wird zugunsten knapper User Stories häufig auf ausführliche Spezifikationen verzichtet. Ohne saubere Akzeptanzkriterien und ohne fachliche Prozessmodelle wie BPMN entstehen Missverständnisse. Beschrieben wird meist nur der goldene Weg, also der Idealfall. Seltene Ausnahmen, Fehlerbehandlungen und Folgeprozesse bleiben ausgeblendet, was zu Lücken in der späteren Systemanpassung führt.
Den Beteiligten fehlt zudem oft eine gemeinsame Sprache. Fachbereiche denken in Business-Begriffen, während die IT logische und systemische Regeln benötigt. Wo das Bindeglied fehlt, typischerweise ein Business Analyst, bleiben die Beschreibungen vage.
Workshops, Reviews und Backlog Refinements sind die etablierten Praktiken, um Anforderungen nach der ersten Einreichung zu verbessern. Eine klare Definition of Ready hilft, das Niveau dieser Formate zu sichern. Diese Praktiken sind notwendig und wertvoll, setzen aber alle nach der Einreichung an, also zu einem Zeitpunkt, an dem die Anforderung bereits in Umlauf gebracht wurde. Vertagungen, Nachschärfungen und Eskalationen sind die häufigen Folgen einer solchen rein reaktiven Qualitätskontrolle.
Das Role-Based Decision & Process Simulation Framework setzt davor an. Durch die iterative Konsultation virtueller Rollen entsteht ein konsolidierter Entscheidungsreport mit Governance-Status, Rollenkonflikten, Risiko-Klassifizierung, Pattern-Empfehlungen, Architektur-Skizze und nächsten Schritten. Dadurch gelangt die Anforderung in einem deutlich tragfähigeren Zustand ins Backlog Refinement. Auch dort, wo eine Anforderung bereits Lösungsansätze enthält, die im Unternehmen akzeptiert sind, lassen sich diese gegen die fachliche und technische Sicht der relevanten Rollen prüfen.
Die Methode ist aus rund zwanzig Jahren Praxis in Prozess- und Requirements Engineering in agilen Software-Entwicklungs-Kontexten entstanden, mit Schwerpunkten in Banking, Versicherung und Medien. Konzeptioneller Bezugspunkt ist die Schwarmintelligenz-Idee aus offenen Multi-Agent-Engines wie MiroFish. Die Implementierung, die Rollen-Spezifikationen, die Konsolidierungs-Logik und die domänenbezogene Anwendung auf Enterprise-Entscheidungsvorbereitung sind eigene Arbeit.
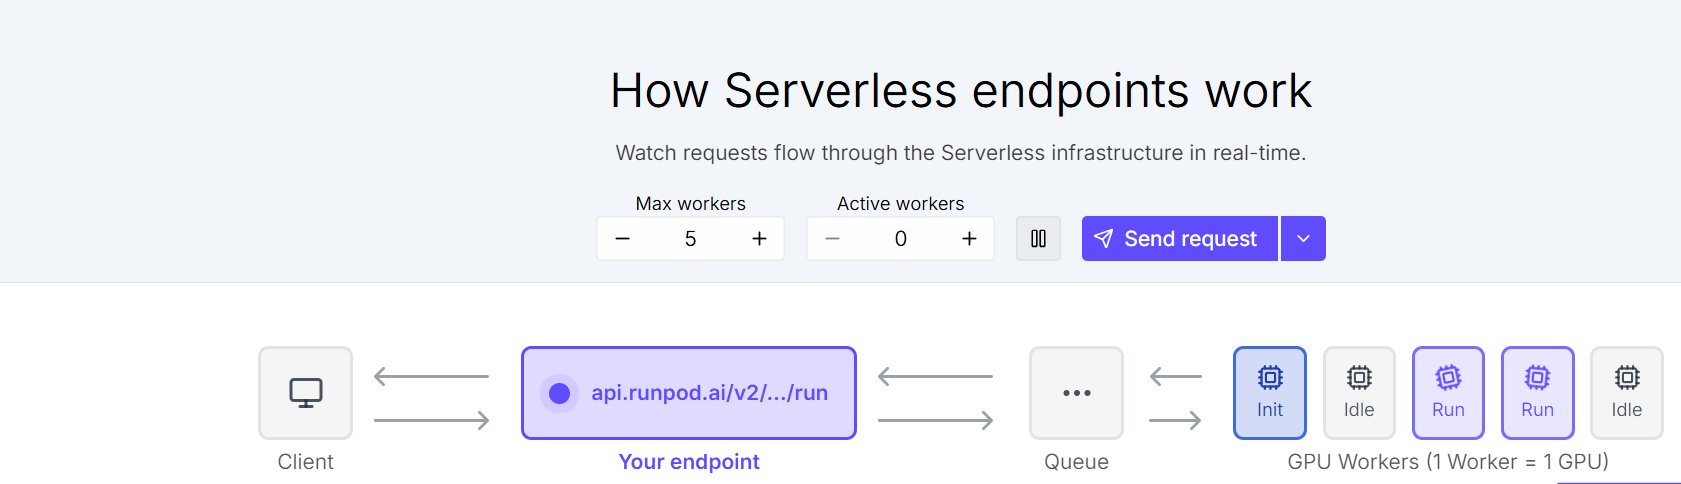
Die hier gezeigte Schicht ist eine Präsentations- und Demonstrations-Schicht. Der fachlich abgeschlossene Referenzstand von MVP 1.0 und MVP 1.1 wurde lokal auf dem NAB9 erarbeitet. Die technische Weiterentwicklung von MVP 2.0 läuft inzwischen getrennt in einer RunPod-GPU-Umgebung. Die Seite trennt deshalb historische NAB9-Evidence, aktuelle GPU-Evidence und noch offene methodisch identische Vergleichsmessungen. Serverless, Multi-GPU, Grossmodelle und Langkontext bleiben klar gekennzeichnete Ausbaustufen und keine aktuelle Produktivbehauptung.
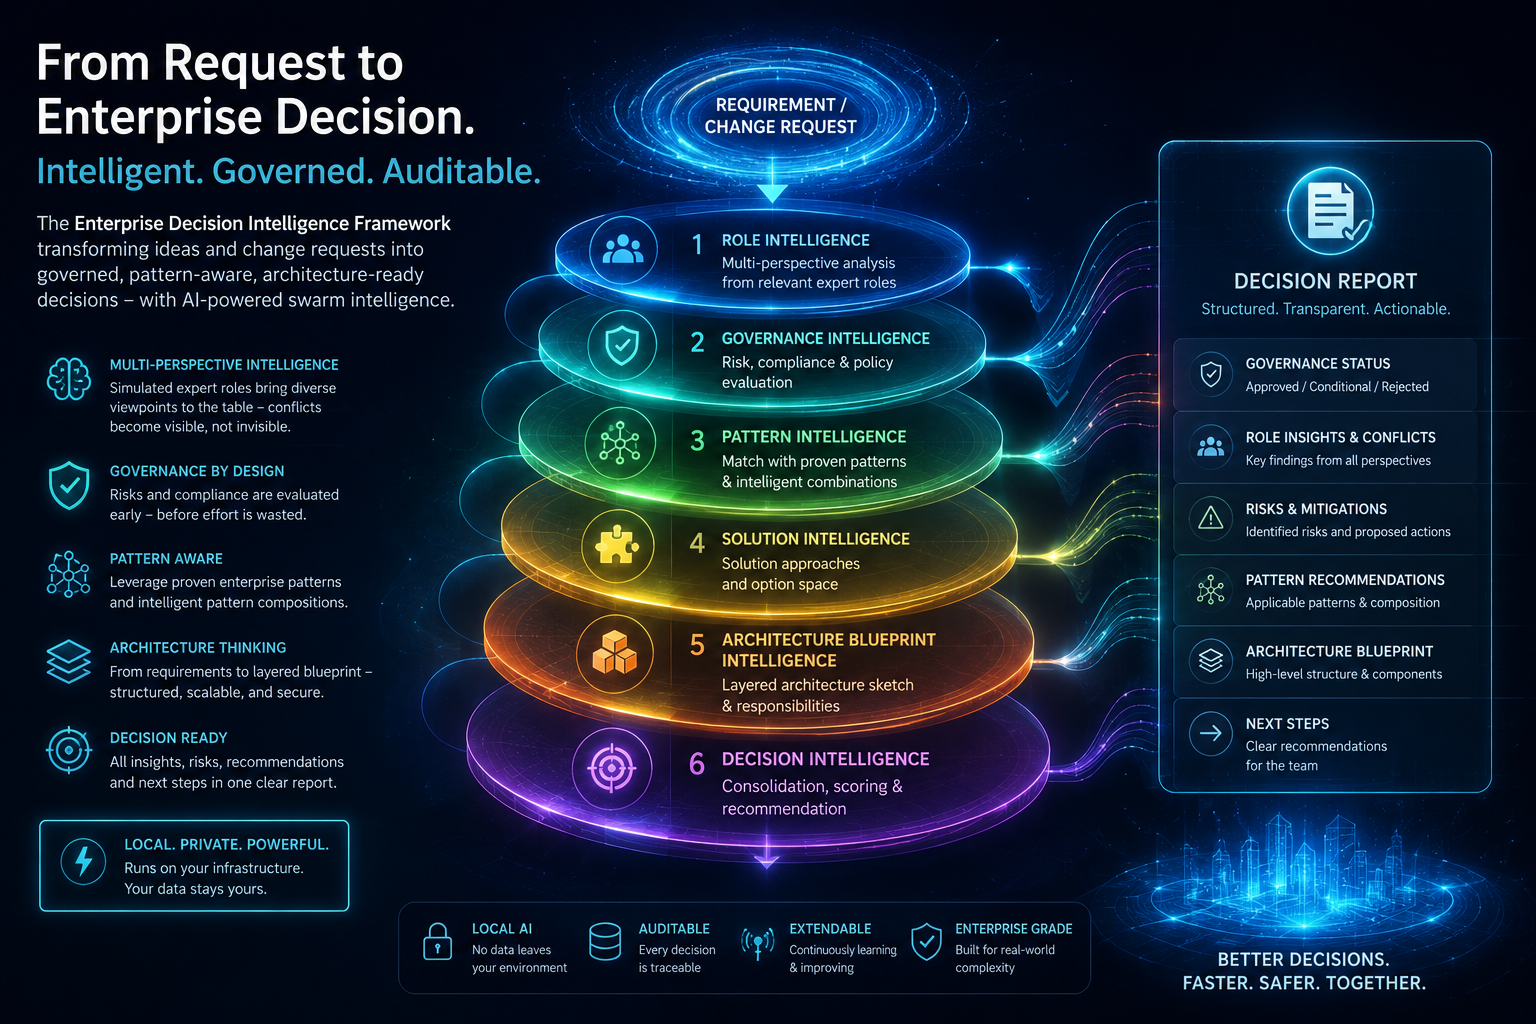
Das Framework arbeitet in mehreren aufeinander aufbauenden Intelligence-Schichten. Eine Anforderung durchläuft sie als Sequenz, am Ende steht ein konsolidierter Entscheidungsreport.
Die Kette verläuft von Requirements oder Change Request über Role Intelligence, Governance Intelligence, Pattern Intelligence, Solution Intelligence, Architecture Blueprint Intelligence und Decision Intelligence zum Entscheidungsreport. Jede Schicht baut auf den Ergebnissen der vorhergehenden auf.
🔍 Vergrössern
Die folgenden sechs Karten erläutern jede Schicht im Detail. Farbe und Nummer der Karten entsprechen der jeweiligen Schicht in der Grafik oberhalb.
Mehrere spezialisierte Rollen erheben parallel ihre Sichten auf den Antrag. Konflikte zwischen Rollen werden sichtbar gemacht, nicht aufgelöst.
Risiken werden früh erkannt und klassifiziert. Kritische Anträge können gestoppt werden, bevor sie weitere Ressourcen binden. Governance-by-Design.
Die Anforderung wird gegen wiederkehrende Lösungs- und Strukturmuster geprüft. Passende Muster und sinnvolle Kombinationen werden benannt.
Aus Rollen-Perspektiven und Mustern entsteht ein Lösungsraum mit fachlichen Optionen, ohne Festlegung auf eine konkrete technische Umsetzung.
Eine fachlich-technische Zielstruktur mit klaren Verantwortungsgrenzen entsteht. Frontend, API, Sicherheit, Audit und Speicher werden sauber getrennt.
Alle Vorschichten werden zu einer Entscheidungsgrundlage verdichtet. Empfehlung, Risiko-Klassifizierung und Handlungsoptionen kommen zusammen.
Aus dieser Sequenz entsteht der Entscheidungsreport mit sechs strukturierten Komponenten. Die Farbe einer Komponente verweist auf die Quell-Schicht in der Grafik.
Freigegeben, mit Auflagen oder Abgelehnt, mit Begründung.
Kernerkenntnisse und Spannungsfelder aus allen Rollen-Sichten.
Identifizierte Risiken mit vorgeschlagenen Massnahmen.
Anwendbare Muster und sinnvolle Kombinationen.
High-Level-Struktur und Verantwortungsbereiche.
Klare Handlungsempfehlungen für das Umsetzungsteam.
Funktionsweise · Reflexion
Was das Framework leistet
Sechs Perspektiven statt Einzellösung, frühe Risikoerkennung und Governance-by-Design in einer Sequenz. Auditierbar, erweiterbar, Enterprise-tauglich. Lokaler KI-Betrieb hält Daten im Unternehmen.
Roadmap
Target Architecture Intelligence als spätere Schicht entwickelt die heutige Blueprint-Schicht zur mittelfristigen Zielarchitektur weiter. Derzeit Ausblick, nicht Teil des aktuellen Standes.
AUSBLICKBewusste Grenzen der Offenlegung
Rollen-Konsultation, Bewertungs- und Konsolidierungsmechanismen sind nicht-öffentliche Eigenarbeit. Die Sektion macht die strukturelle Komplexität sichtbar, ohne die Implementierungs-Mechanik offenzulegen.
Wert des Frameworks
Der Wert liegt in der Verbindung von Business-Analyse, Governance, Pattern Intelligence, Solution-Denken, Architekturdenken und Entscheidungsmodell zu einer Sequenz. Diese Verbindung ist nicht trivial nachzubauen.
Die folgenden Schichten sind Beispiele aus einem grösseren Spektrum möglicher Anwendungsfälle. Welche Schichten in einem konkreten Unternehmen relevant werden, hängt von der Reifegrad-Stufe der dortigen Prozesse und der internen Governance-Kultur ab.
Pre-Distribution-Schärfung
BA-, PO- und Process-Owner-Empowerment
Proaktive Eigeninitiative gegenüber dem Sponsor
Budget- und Portfolio-Steuerung
Ressourcen- & Kapazitätsplanung
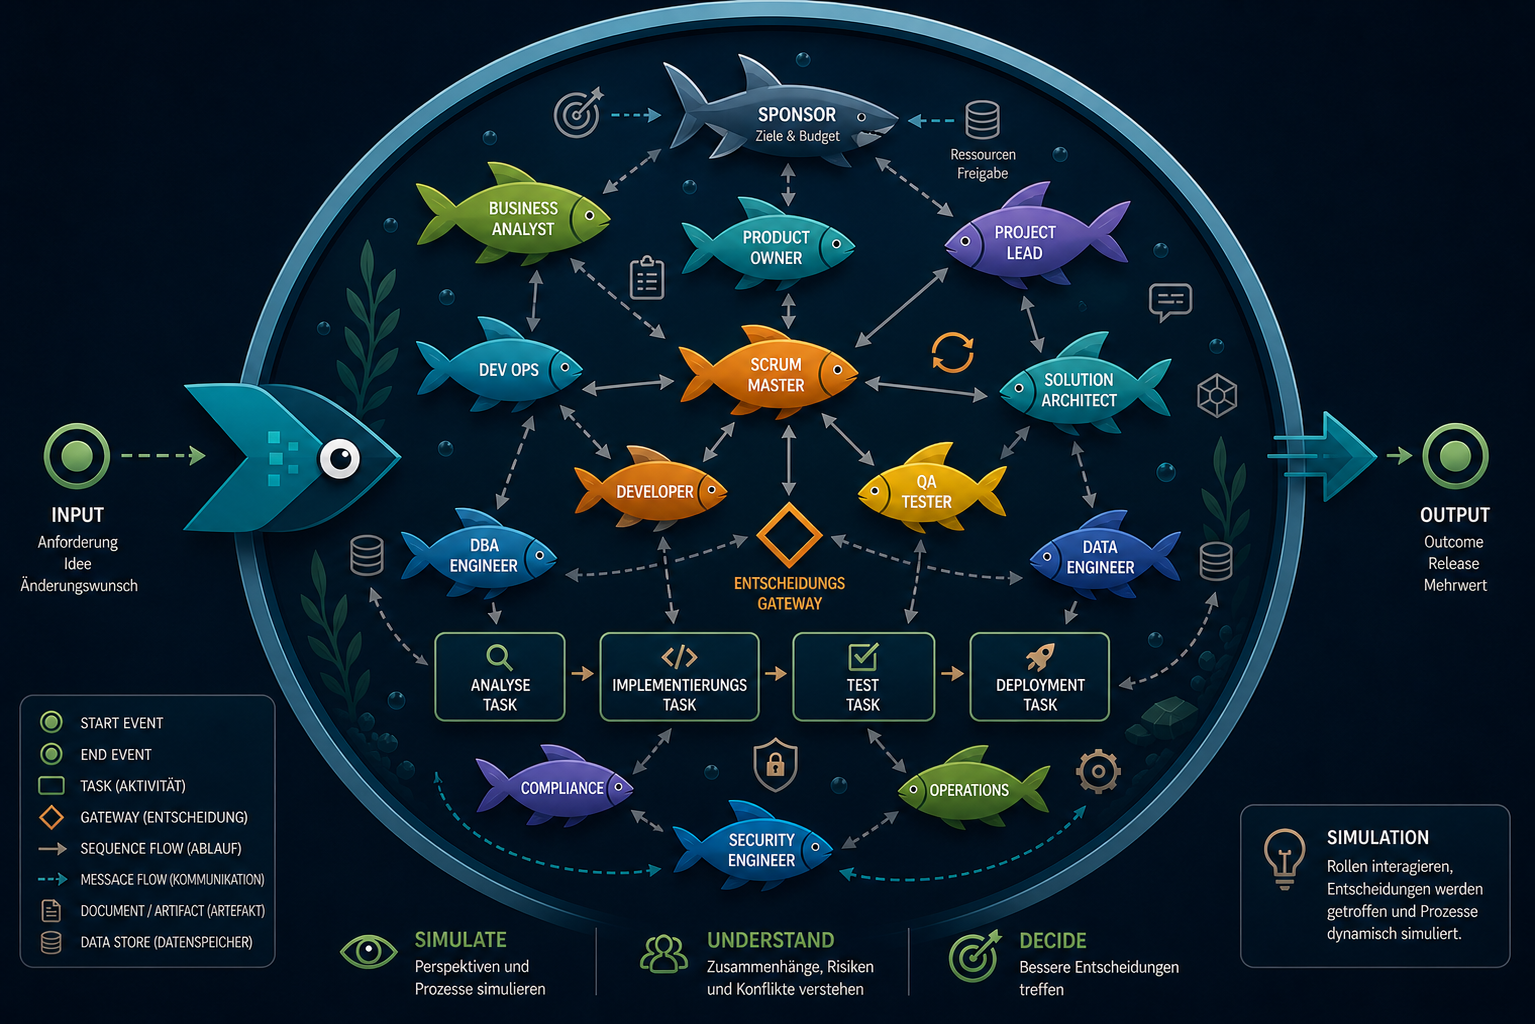
Die rollenbasierte Konsultation arbeitet mit zwei klar getrennten Strukturen. Der Sponsor steht ausserhalb des Schwarms als Mandatsgeber. Der Schwarm besteht aus mehreren Rollen-Gruppen, deren Sichtweisen parallel erhoben und gegeneinander geprüft werden.
Sponsor
Vision · Ressourcen · Mandat · Rückendeckung
Zehn Rollen-Gruppen im Schwarm
Business Analysis
Anforderungen, Akzeptanzkriterien
Product & Strategy
Produktvision, Priorisierung
Engineering & Architecture
Umsetzbarkeit, Architektur
Quality & Testing
Testbarkeit, Qualität
Security & Compliance
Security, Compliance
Operations & Runtime
Betrieb, Monitoring
Process Governance
Prozess, Governance
Delivery & Collaboration
Delivery, Sprintfähigkeit
UX & Experience
Nutzerwert, Bedienbarkeit
AI Governance
KI-Governance, Kontrolle
Die innere Konfiguration der Rollen und die Mechanismen ihrer Konsultation sind Teil der nicht-öffentlichen Eigenarbeit. Diese Sektion macht die Struktur der Konstellation sichtbar, ohne die operative Mechanik offenzulegen.
Die Sektion trennt drei Ebenen: den abgeschlossenen lokalen Referenz- und Evidenzstand auf dem NAB9, die aktive separate MVP-2.0-Entwicklung auf RunPod und spätere externe beziehungsweise serverlose Ausbaustufen. Auf dem NAB9 wurden MVP 1.0 und MVP 1.1 reproduzierbar mit qwen2.5:3b und qwen2.5:7b ausgewertet. Auf RunPod steht inzwischen eine dedizierte NVIDIA RTX 3090 mit 24 GB VRAM zur Verfügung.
Erste kurze GPU-Inferenzmessungen und ein vollständiger Fünf-Rollen-Gruppenlauf sind vorhanden. Sie zeigen die neue Leistungsklasse, ersetzen aber noch keinen methodisch identischen pp2048/tg256-Benchmark und keine vollständig gematchte Wiederholung von 434c, dbf0 und b6a0. Genau diese Trennung bewahrt die Vergleichbarkeit.
Abgeschlossener lokaler Referenzstand. Die NAB9-Ausführung bleibt die belastbare Baseline für llama-benchy, MVP-1.0-Runs und die vollständige MVP-1.1-CR-Staffelung.
Die aktive GPU-Entwicklung nutzt ein separates GitHub-Repository für MVP 2.0 und eine persistente Modellablage. Der methodisch identische Benchmark bleibt ausstehend.
Diese Stufe ist als Ausblick angelegt und nicht Teil des aktuellen Standes. Sie ist auf unsensible Anwendungsfälle oder anonymisierte Auswertungen beschränkt und setzt eine interne Freigabe durch die zuständigen Compliance-Funktionen voraus.
Lokale CPU-Referenz und aktive GPU-Entwicklungsumgebung mit einheitlichen Kennzahlen gegenübergestellt.
| Kennzahl | NAB9 lokal | RunPod GPU |
|---|---|---|
| Recheneinheit | Intel i9-12900HK | NVIDIA RTX 3090 |
| Dedizierter VRAM | keiner | 24 GB GDDR6X |
| Ausführung | CPU | CUDA |
| GPU-Offloading | nein | 100 % |
| Ollama | 0.23.1 | 0.32.1 |
| Python | 3.12.3 | 3.11.10 |
| Modellablage | lokal | 60 GB Network Volume |
| Plattform | Ubuntu-VM | RunPod GPU Container |
| Aktueller Projektstand | MVP 1.0 / 1.1 abgeschlossen | MVP 2.0 aktiv |
qwen2.5:3b · beobachteter Generierungsdurchsatz
Beobachteter Durchsatz: 12,72 Token/s auf dem NAB9 gegenüber 162 Token/s auf der RTX 3090. Das entspricht in den bisher vorliegenden Messungen rund 12,7-mal höherem beobachtetem GPU-Durchsatz.
Die Werte stammen noch aus unterschiedlichen Messprofilen: NAB9 = llama-benchy pp2048/tg256, fünf Läufe. RunPod = kurzer 21-Token-GPU-Test. Der methodisch identische RunPod-Gegenbenchmark steht noch aus.
Vertiefung pro Stufe
| Host-System | |
|---|---|
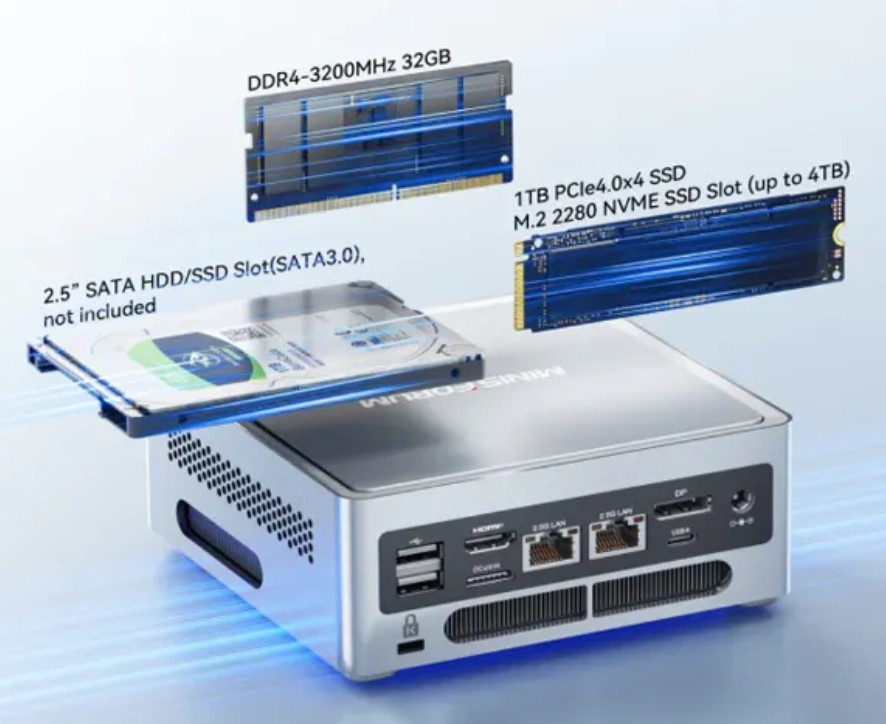
| Gerät | NAB9 Venus |
| CPU | i9-12900HK |
| Kerne / Threads | 14 / 20 |
| RAM | 64 GB DDR4 |
| RAM-Aufbau | 2 × 32 GB |
| GPU | Iris Xe, 96 EU |
| Storage | ca. 5,7 TB |
| Host-OS | Win 10 Pro 25H2 |
| Virtualisierung & Gast | |
|---|---|
| Plattform | VMware WS Pro 25 |
| Ziel-VM | DecisionCoreSystem |
| Gast-OS | Ubuntu 24.04 LTS |
| Codename | noble |
| Container | Docker 29.1.3 |
| Verwaltung | Portainer :9000 |
| Runtime & Entwicklung | |
|---|---|
| LLM-Runtime | Ollama 0.23.1 |
| Python | 3.12 |
| Git | 2.43.0 |
| Modell A (MVP 1.0) | qwen2.5:3b | 1,9 GB |
| Modell B (MVP 1.1) | qwen2.5:7b | 4,7 GB |
| Modell-Volumen | ca. 6,6 GB |
Gemessen wurde lokal auf dem NAB9 ohne dedizierte GPU: Ollama 0.23.1 und llama-benchy 0.4.0 mit qwen2.5:3b und qwen2.5:7b, 2048 Prompt-Tokens, 256 Output-Tokens, fünf Läufen und Concurrency 1.
Einordnung: Im konkreten technischen Profil war 3B insgesamt ungefähr 2.05-mal schneller; über die drei isolierten Agentenläufe ungefähr 2.46-mal. 3B eignet sich damit als schneller lokaler Prüfstand. 7B lieferte bei Business Analyst und Product Owner tiefere und strukturiertere Ergebnisse.
Grenze und Stufe 2: Erste RunPod-GPU-Smoke-Werte und ein vollständiger Fünf-Rollen-Gruppenlauf sind vorhanden. Sie sind wegen unterschiedlicher Messprofile noch kein methodisch identischer Gegenwert zum NAB9-Benchmark. Der direkte pp2048/tg256-Vergleich und gematchte Wiederholungen von 434c, dbf0 und b6a0 stehen aus.
| GPU & Compute | |
|---|---|
| GPU | 1 × NVIDIA GeForce RTX 3090 |
| VRAM | 24 GB GDDR6X |
| Compute Capability | 8.6 |
| CUDA-Ausführung | verifiziert |
| GPU-Offloading | 100 % |
| Runtime & Storage | |
|---|---|
| Runtime | Ubuntu RunPod GPU Container |
| Ollama | 0.32.1 |
| Python | 3.11.10 |
| Storage | 60 GB Network Volume |
| Modellablage | persistent auf Network Volume |
| Projekt & Modelle | |
|---|---|
| Repository | Enterprise-Decision-Intelligence-Framework-MVP-2.0 |
| Branch | main |
| Übergabe-HEAD | 93f49ce |
| Modelle | qwen2.5:3b, qwen2.5:7b |
| Kontext | 4096 |
Die folgenden Werte trennen einen kurzen Ollama-Smoke-Test von einem vollständigen Decision-Lab-Gruppenlauf. Sie zeigen die neue Leistungsklasse, sind aber noch kein methodisch identischer pp2048/tg256-Vergleich mit dem NAB9.
| Technische Spezifikation | |
|---|---|
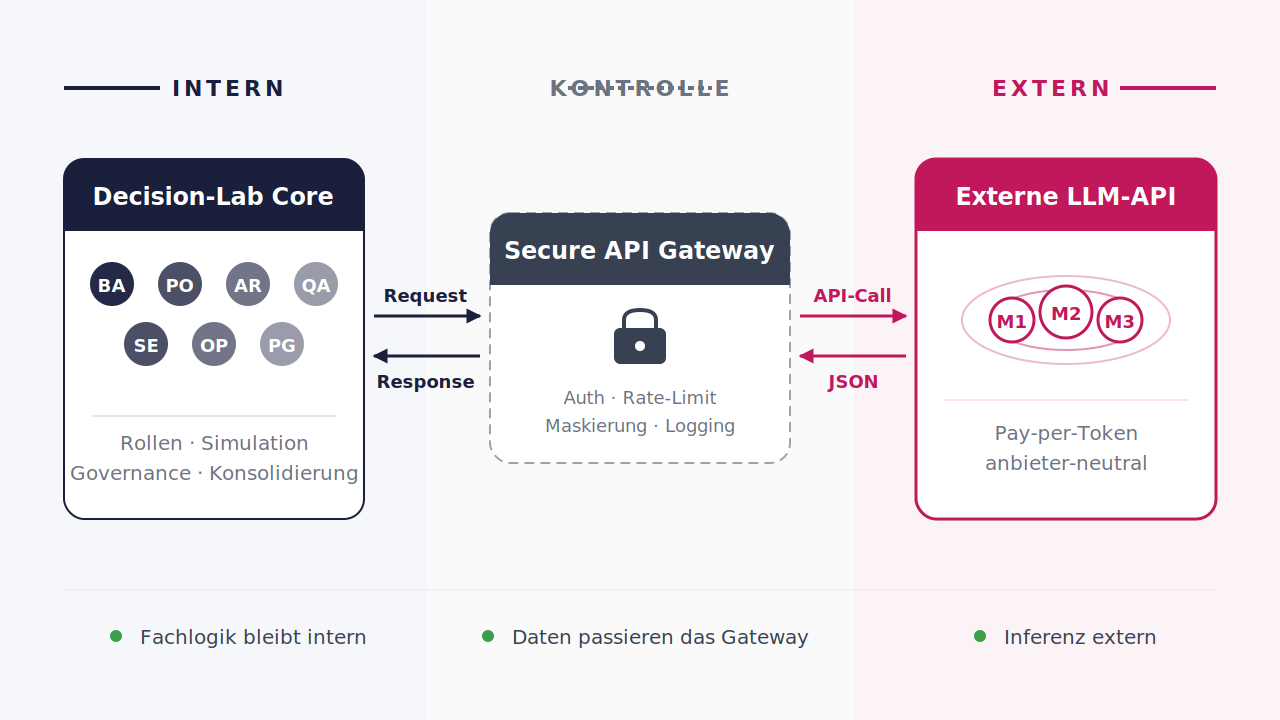
| Integration | REST / HTTPS |
| Authentisierung | API Key / Service Account / Backend Proxy |
| Datenfluss | kontrolliert, protokolliert |
| Output | strukturierte JSON-Antwort |
| Governance | Policy- und Freigabelogik |
| Kostenmodell | nutzungsabhängig |
| Voraussetzung | Datenschutz und Compliance |
Die hier beschriebenen Architektur-Stufen markieren die heutige Reife und den vorgesehenen Wachstumspfad. Konkrete Konfigurations-Details der LLM-Runtime, der Speicher-Strategie und der internen Kommunikations-Mechanismen sind Teil der nicht-öffentlichen Eigenarbeit.
Die Sektion beschreibt die fachliche Herkunft des Frameworks, den konzeptionellen Bezug zu vorhandenen Open-Source-Arbeiten und die Abgrenzung der eigenständigen Anteile.
Das Framework ist aus 20 Jahren Business-Analyse-Praxis in Banking, Versicherung und Medien gewachsen. Stationen umfassen unter anderem Mandate bei Credit Suisse, BANK-now, ElipsLife (Swiss Re) und Goldbach Media (Tamedia). Die formale Methodengrundlage umfasst die Zertifizierungen IREB Certified Professional for Requirements Engineering und IPMA Level D. Ergänzend wurde der MAS in Business Process Engineering an der FHS St. Gallen abgeschlossen. Wiederkehrende Muster aus diesen Mandaten sind in die rollenbasierte Konsultation und in die Bewertungs-Strukturen eingeflossen.
Der visuelle und konzeptionelle Anker für die Schwarm-Metaphorik ist das Open-Source-Projekt MiroFish, eine Schwarmintelligenz-Engine auf Basis der Frameworks OASIS und CAMEL-AI, veröffentlicht unter der Lizenz AGPL-3.0. Übernommen wurden der konzeptionelle Ansatz der parallelen Konsultation mehrerer virtueller Rollen sowie die Aquarium- und Fisch-Metaphorik in der Visualisierung. Eigenständig entwickelt wurden der gesamte produktive Code, die Spezifikation der Rollen und Rollen-Gruppen, die Konsolidierungs-Logik und die Übertragung auf den Enterprise-Decision-Vorbereitungs-Kontext. Die Lizenz-Pflichten gegenüber MiroFish sind dort relevant, wo Code übernommen wurde, was in der hier beschriebenen Eigenentwicklung nicht der Fall ist.
Der eigentliche Wert des Frameworks liegt nicht in einer einzelnen technischen Komponente, sondern in der Verbindung von Business-Analyse, Governance-Denken, Pattern-Wissen, Solution-Räumen, Architektur-Skizzen und Entscheidungs-Verdichtung zu einer durchgängigen Sequenz. Diese Verbindung ist über Jahre gewachsen, in der Praxis erprobt und durch die domänen-spezifischen Inhalte der Rollen unterlegt. Sie ist in dieser Form nicht trivial nachzubauen.
Die konkreten Inhalte der Rollen-Wissensbasen, die internen Bewertungs- und Konsolidierungs-Algorithmen sowie die Konfiguration der Iterations-Schritte bleiben Teil der nicht-öffentlichen Eigenarbeit. Diese Sektion macht die Herkunft und die Eigenständigkeit sichtbar, ohne die innere Mechanik offenzulegen.
Für ein Gespräch zur Anwendbarkeit im eigenen Unternehmen oder für konkrete Anfragen zu Mandaten und Festanstellungen.